Générer mot de passe python
Bonjour,
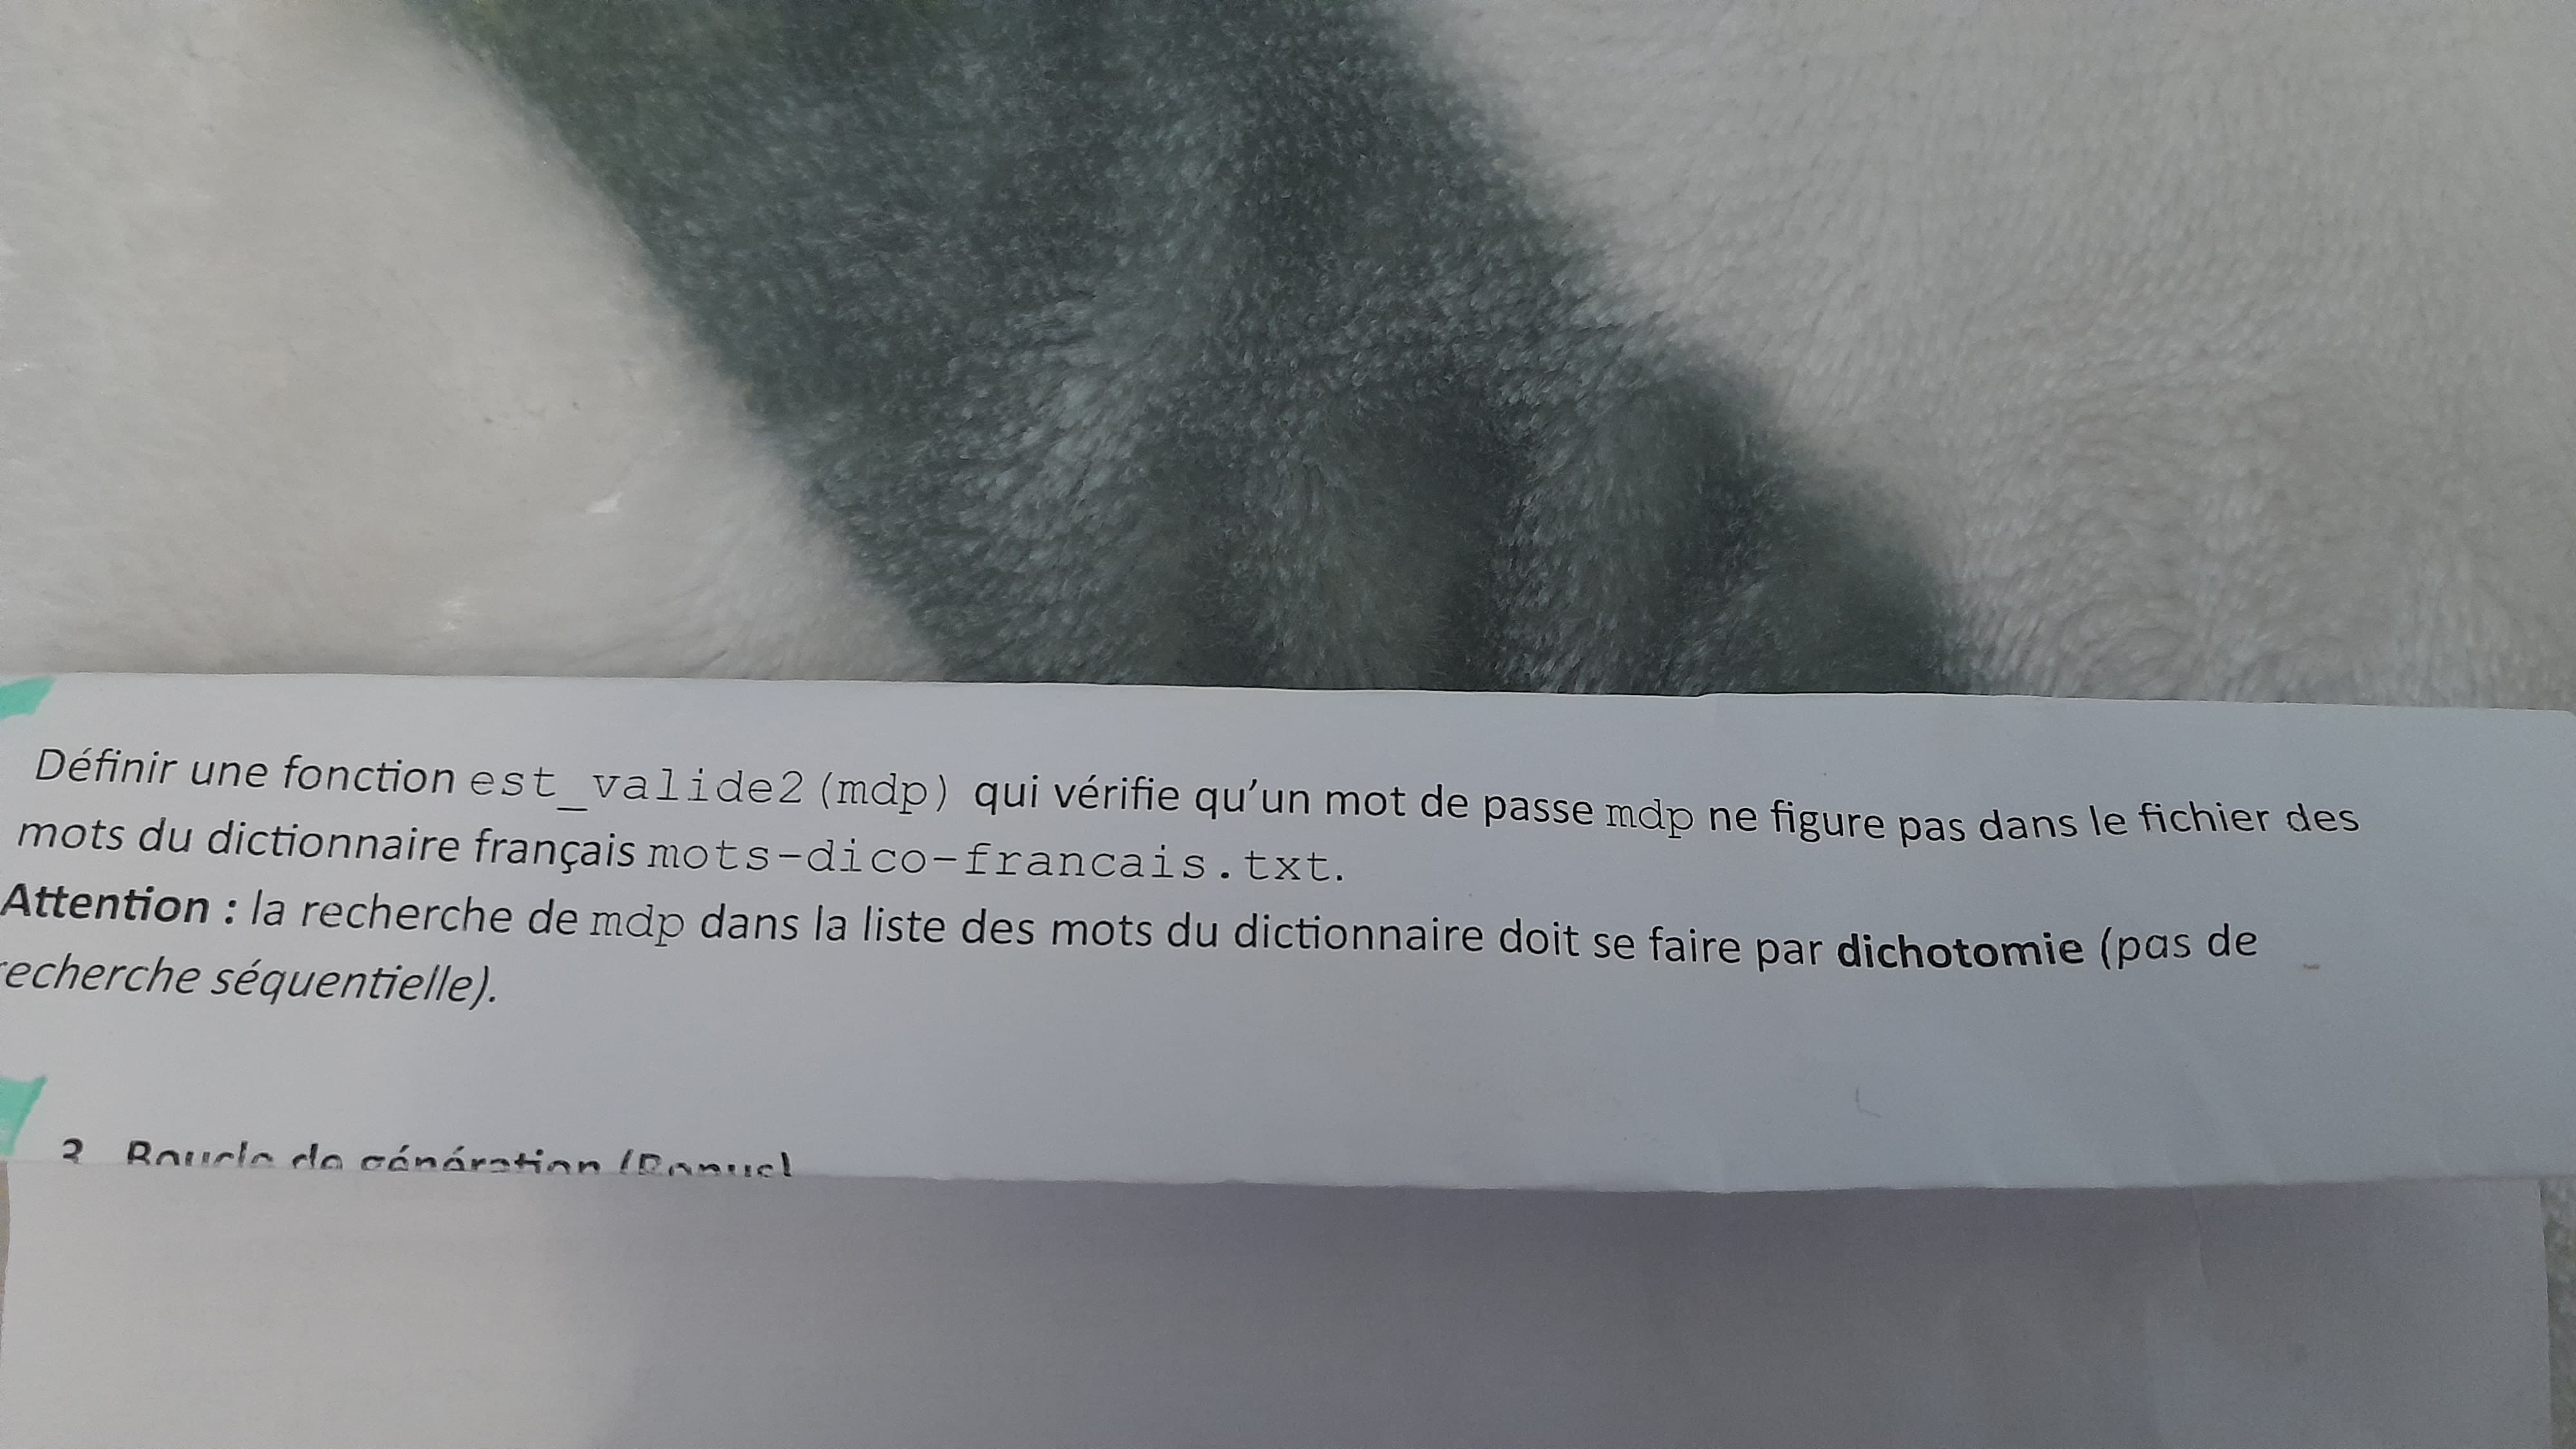
J ai un exercice de première nsi
Android / SamsungBrowser 29.0
2 réponses
-
Modérateur
Bonjour,
Il est d'usage que l'on ne fasse pas les exercices à la place des élèves ;-)
Tu dois commencer à écrire le code est alors nous pourrons t'aider. Il y a un mot clé dans l'énoncé : dichotomie, effectue une recherche sur cette technique.
-
Modérateur
Bonjour,
Un bon début serait de nous montrer ce que tu as commencé à coder et nous dire ce qui te bloque.
Voici par exemple à quoi correspondrait une recherche séquentielle :
#!/usr/bin/env python3

filename = "/usr/share/dict/french"

with open(filename, "r") as f:
    words = [line.strip() for line in f.readlines()]


def search1(words: list[str], searched: str) -> bool:
    # Recherche en O(n)
    for w in words:
        if w == searched:
            return True
    return False


def search2(words: list[str], searched: str) -> bool:
    # Recherche en O(n)
    return searched in words


for searched in ("mot", "azreazeaz"):
    print(f"{searched=}")
    print(f"{search1(searched)=}")
    print(f"{search2(searched)=}")
Résultat :
searched='mot'
search1(searched)=True
search2(searched)=True
searched='azreazeaz'
search1(searched)=False
search2(searched)=False
Les deux fonctions search1 et search2 font toutes deux un parcours de la liste de mots chargés et s'arrête dès que le mot est trouvé. Dans le pire cas, toute la liste de mot est examinée. Si la liste de mot contient n mots, on dit que la complexité de ces algorithmes est en O(n). C'est donc ce que ne veut pas ton enseignant.
Maintenant, si on change très légèrement le code de sorte à utiliser un set (ensemble) plutôt qu'une liste, la fonction search2 est réalisée en O(1) en moyenne (voir ici).
#!/usr/bin/env python3

filename = "/usr/share/dict/french"

with open(filename, "r") as f:
    words = {line.strip() for line in f.readlines()}  # set


def search1(words: set[str], searched: str) -> bool:
    # Recherche en O(n)
    for w in words:
        if w == searched:
            return True
    return False


def search2(words: set[str], searched: str) -> bool:
    # Recherche en O(n)
    return searched in words


for searched in ("mot", "azreazeaz"):
    print(f"{searched=}")
    print(f"{search1(words, searched)=}")
    print(f"{search2(words, searched)=}")
C'est ce qu'on écrirait en pratique. Mais ça n'est toujours pas ce que veux ton enseignant, qui souhaite une solution plus compliquée à écrire, moins performantes (car en O(log(n)) et qui présuppose que la liste de mot est triée.
Donc heureusement en python, on peut facilement trier une liste (et donc ne pas faire d'hypothèse sur le contenu du fichier) à l'aide de la fonction sorted (qui soit dit en passant, s'exécute en O(n.log(n)), voir ici. Donc le début de ton pourrait ressembler à ceci :
#!/usr/bin/env python3 filename = "/usr/share/dict/french" with open(filename, "r") as f: words = sorted(line.strip() for line in f.readlines()) def dichotomie(words, searched: str) -> bool: # Recherche en O(log(n)) # <A COMPETER> for searched in ("mot", "azreazeaz"): print(f"{searched=}") print(f"{dichotomie(words, searched)=}")Bonne chance