Code python ne s’exécute pas
Bonjour,
je veux appliquer les deux méthodes K-means et classification hierarchique ascdente sur une matrice de similarité pour identifier les differentes cluster,
j'ai réalisé un code python, mais j'ai une erreur d'execution:
"
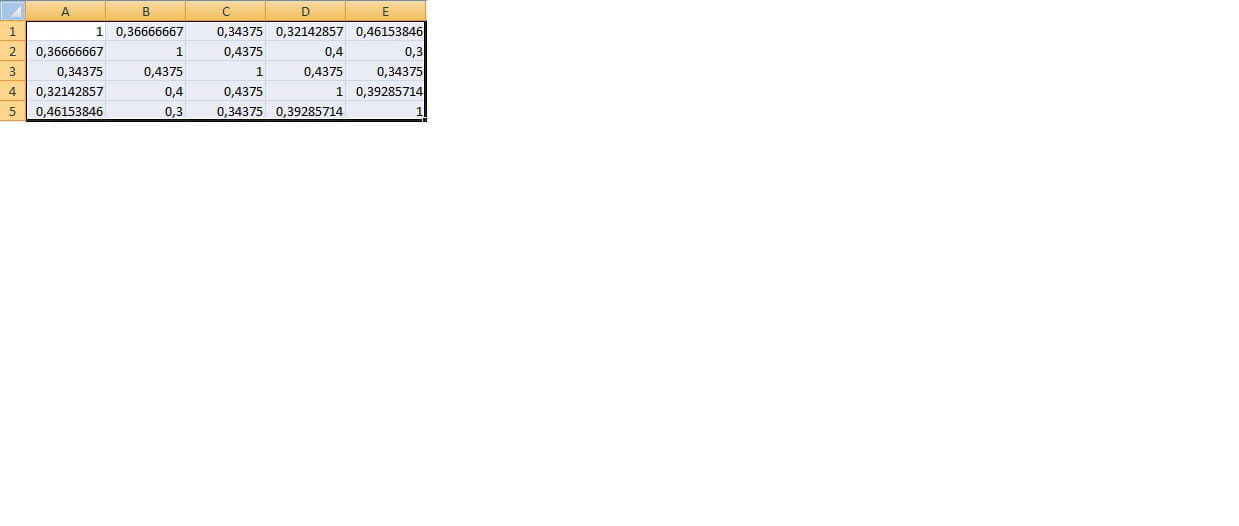
ValueError: could not convert string to float: '0,366666667'
voici mon code:
merci d'avance pour vos aides
je veux appliquer les deux méthodes K-means et classification hierarchique ascdente sur une matrice de similarité pour identifier les differentes cluster,
j'ai réalisé un code python, mais j'ai une erreur d'execution:
"
ValueError: could not convert string to float: '0,366666667'
voici mon code:
import pandas as pd
from pandas import read_csv
import numpy as np
from matplotlib import pyplot as plt
from pylab import rcParams
from scipy.cluster.hierarchy import dendrogram
from sklearn.cluster import AgglomerativeClustering, KMeans


# figure size
rcParams['figure.figsize'] = 70, 40


def plot_dendrogram(model, labels, **kwargs):
    """ Create linkage matrix and then plot the dendrogram """

    # create the counts of samples under each node
    counts = np.zeros(model.children_.shape[0])
    n_samples = len(model.labels_)

    for i, merge in enumerate(model.children_):
        current_count = 0
        for child_idx in merge:
            if child_idx < n_samples:
                current_count += 1  # leaf node
            else:
                current_count += counts[child_idx - n_samples]
        counts[i] = current_count

    linkage_matrix = np.column_stack([model.children_, model.distances_,
                                      counts]).astype(float)

    # Plot the corresponding dendrogram
    dendrogram(linkage_matrix, labels=labels, **kwargs)


def main(sim_mat, names):

    # load the similarity matrix
    df = pd.read_csv(sim_mat, delimiter=";", header=None)
    matrix = df.to_numpy()

    # perform the clustering
    model_1 = AgglomerativeClustering(n_clusters=None, affinity="precomputed",
                                      linkage="average", distance_threshold=0)

    # NOTE the number of clusters is here!!
    model_2 = KMeans(n_clusters=40)

    # get the names
    de = pd.read_csv(names, encoding="latin-1", header=None)
    labels = de[0].to_list()

    # print("Sizes:", matrix.shape, len(labels))

    model_1 = model_1.fit(matrix)
    model_2 = model_2.fit(matrix)
    return model_1, model_2, labels


if __name__ == "__main__":

    model_1, model_2, labels = main(sim_mat='C:/Users/click/Desktop/doctorat/rfiddd/fichier trouvé resultats/2020-07-22/FDA_matrice_bisim.csv',
                                    names='C:/Users/click/Desktop/doctorat/rfiddd/fichier trouvé resultats/2020-07-22/FDA_med-unique.csv')

    # print the KMeans results
    print("KMeans results")
    for name, cluster in zip(labels, model_2.labels_):
        print(f"- {name:<25}: {cluster}")

    # plot the top three levels of the dendrogram
    print("\nCreating the dendrogram...")
    plot_dendrogram(model_1, labels=labels, truncate_mode='level')
    plt.savefig("dendrogram.png")
    print("Done!")
merci d'avance pour vos aides
Configuration: Windows / Chrome 85.0.4183.102
6 réponses
-
merci yag_be pour votre aide
j'ai une autre question si c'est possible,
concernant le découpage du dendrogramme, il m'affiche 3 couleurs différente, ça veux dire qu'il a trouver 3 classes, mais dans cas c'est pas logique 3 classes avec 285 échantillon,
comment faire pour corriger le découpage? -
merci yag_be pour votre aide
j'ai une autre question si c'est possible,
concernant le découpage du dendrogramme, il m'affiche 3 couleurs différente, ça veux dire qu'il a trouver 3 classes, mais dans cas c'est pas logique 3 classes avec 285 échantillon,
comment faire pour corriger le découpage? -
j'ai remplacer la virgule par un point, il ma afficher la même erreur mais la valeur suivante, donc c'est ça le problème, alors il faut que je remplace les virgules de (285*285) valeurs par des point
-
les numéros de lignes correspond au fichier python, je travail avec sublime text
j'ai pas compris concernant le remplacement de la virgule par un point,
j'ai copier les fichiers sous image parce que j’arrive pas à envoyer des fichiers csv -
Bonsoir;
merci yg_be pour votre réponse,
mtrice bisim:
matrice FDA_med_unique:
erreur:
- ligne 57
- ligne 65 -
Contributeurbonjour,
peux-tu partager les fichiers nécessaires pour exécuter ton programme?
peux-tu également préciser à quelle ligne l’erreur se produit?